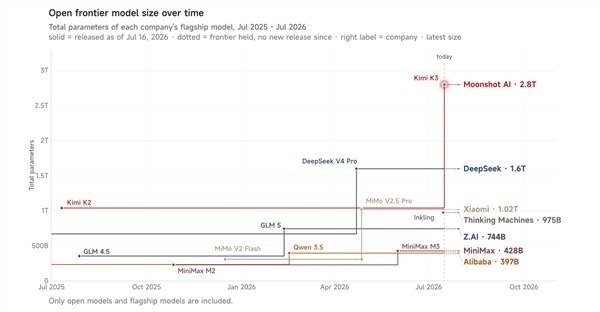
“它不是在写代码,是在带团队干活。”——这是不少工程师试用Kimi K3后的真实反馈。7月17日凌晨,月之暗面甩出一枚硬核炸弹:Kimi K3,2.8万亿参数,全球首个接近3万亿的开源大模型。它没堆砌虚名,直接上硬货:连续48小时不眠不休,用开源EDA工具链从零画出一颗能跑nano模型的小芯片,面积4平方毫米、集成146万个标准单元,还顺手做了仿真验证。这不是PPT里的“可能”,而是GitHub可查、日志可追溯的真实运行记录。
这模型真敢“熬”。剪辑师要干1-2天的短视频,它56段原始素材一扔,自动选片、卡点、调色、配乐、多轮迭代全包圆;科研人员啃两周的天体物理I-Love-Q关系复现,它两小时搞定,读20多篇论文、跑300多种状态方程、揪出已发表公式的矛盾点,输出3000+行代码和交互式仪表盘;连Triton编译器都自己重写了一遍,叫MiniTriton,性能不输原版,还能稳稳训nanoGPT。背后靠的不是蛮力,是KDA混合注意力+注意力残差+Stable Latent MoE——896个专家里每次只调16个,省算力不降智,扩展效率比K2高2.5倍。
当然,它不是神。官方坦荡承认:体验上仍略逊于Claude Fable 5和GPT-5.6 Sol,尤其在模糊指令下容易“自作主张”;对思考历史回传有强依赖,切错上下文就可能翻车。但关键在于——它开源。完整权重7月27日上线,不是“部分开放”,不是“仅限研究”,而是把整套能力交到开发者手里。当别人还在闭源围墙里修花园,中国团队正把3万亿参数的梯子,架在开源社区门口。
有人问,开源3万亿参数模型,图啥?图的不是“刷存在感”,而是把大模型从实验室的奢侈品,变成工程师手边的螺丝刀。你打开Hugging Face,下载Kimi K3权重,配个A100×4就能跑通推理;想微调?官方连LoRA适配器、数据清洗脚本、量化工具链都打包好了,连注释都写得像教徒弟——“这里别改batch size,显存会爆,但可以试试梯度检查点”。这不是炫技,是真怕你卡在第一步。
更实在的是生态落地。深圳一家做工业质检的初创公司,上周用K3重写了缺陷识别Pipeline:原来靠三套模型拼接(分割+分类+定位),现在单模型端到端输出像素级掩码+置信度热力图+根因建议,误检率降了37%,产线部署延迟从2.3秒压到680毫秒。他们没雇新算法工程师,就是两个老Python后端,照着月之暗面在B站发的《K3上手七日谈》视频,边敲边学,五天就上线灰度。这不是孤例——GitHub上已有217个基于K3的衍生项目,从农机播种路径规划,到绍兴黄酒发酵参数预测,甚至有中学老师拿它自动生成物理实验报告批注模板。
当然,路还长。K3目前不支持多模态输入,语音和图像得走API中转;中文长文本逻辑链偶尔会“跳帧”,比如推演碳中和政策影响时,漏掉区域电网调峰这个关键变量。但团队在README里直接贴出待办清单:Qwen-VL融合模块预计Q4合入,数学推理强化补丁已在内部测试。没有“未来将”“计划中”,只有“已排期”“ETA 9月12日”。
说到底,K3的价值不在参数数字多吓人,而在它让“用大模型解决问题”这件事,第一次变得像装个npm包一样自然。当国外同行还在争论“AGI伦理框架该由谁定”,中国开发者已经用K3修好了产线上的PLC控制器、校准了高原气象站的传感器漂移、帮乡村小学生成了带方言配音的科学课动画。技术不喊口号,它只是默默蹲下来,把你手里的活,干得更快一点、更稳一点、更便宜一点。
久融配资提示:文章来自网络,不代表本站观点。